SpiderFoot: OSINT Automation, Reconnaissance e Attack Surface
Scopri SpiderFoot per automatizzare OSINT e reconnaissance: moduli, correlazione, subdomain, IP, email, threat intelligence e attack surface mapping.
- Pubblicato il 2026-02-08
- Tempo di lettura: 8 min
SpiderFoot: OSINT, Reconnaissance e Attack Surface Mapping #
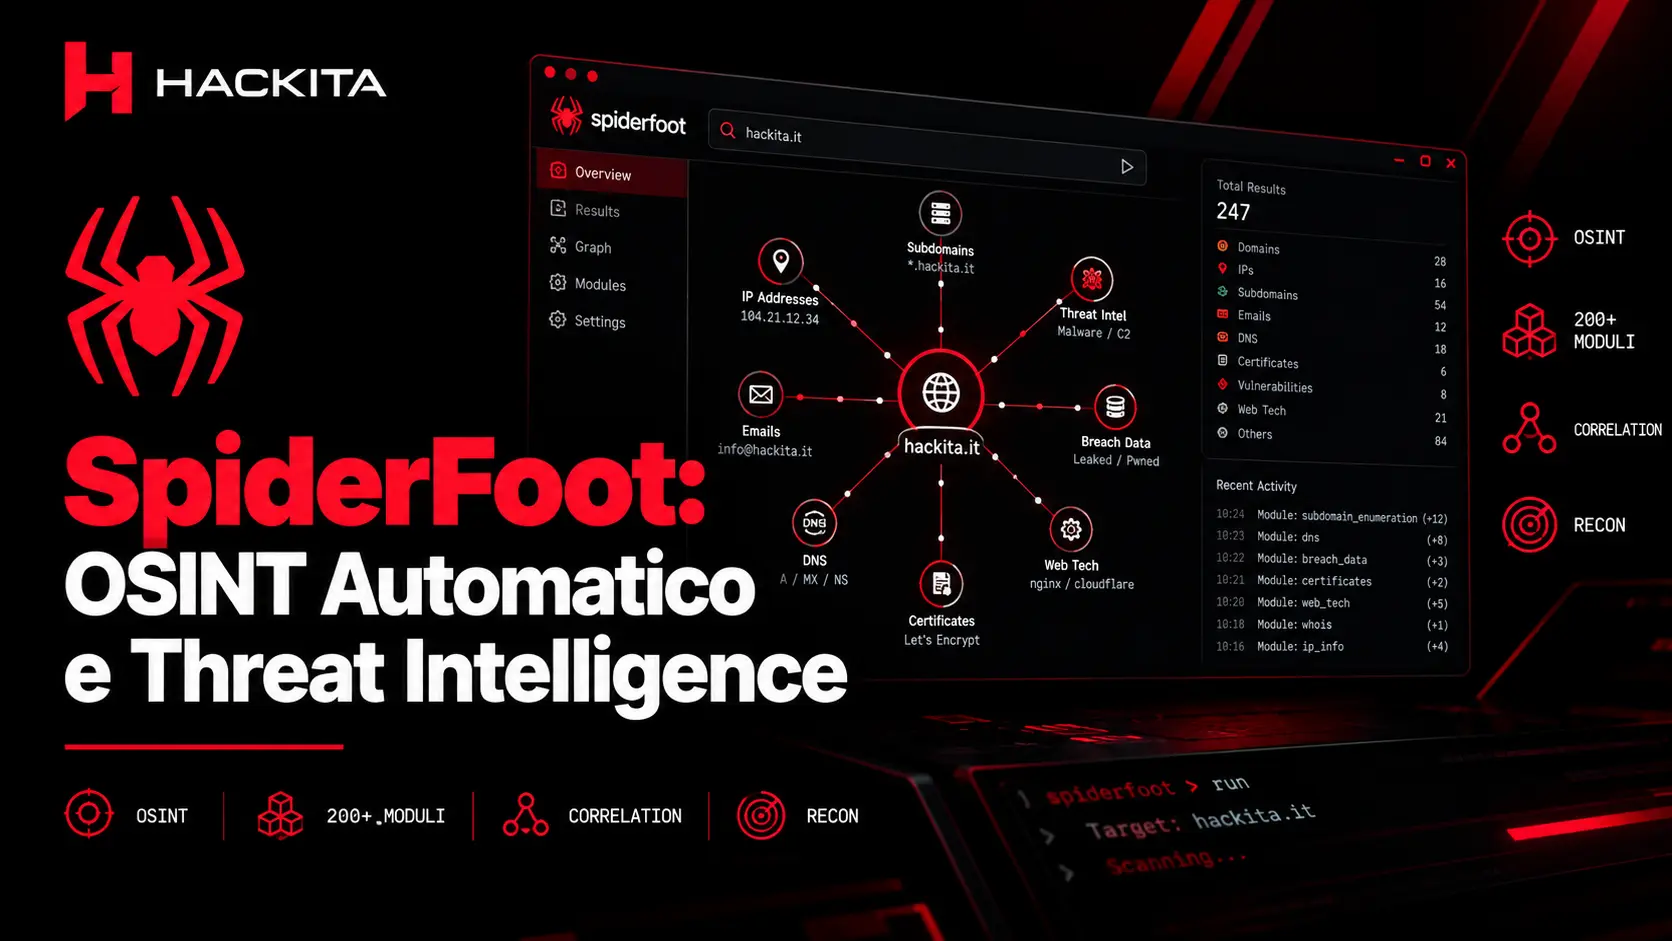
SpiderFoot è uno strumento open source per automatizzare OSINT e reconnaissance. Invece di raccogliere manualmente informazioni da decine di fonti, permette di avviare una scansione su un target e lasciare che i suoi moduli estraggano e correlino automaticamente gli elementi scoperti.
Il tool supporta diversi tipi di target, tra cui domini e sottodomini, indirizzi IP, hostname, subnet, ASN, email, username, numeri di telefono, nomi di persona e indirizzi Bitcoin. I risultati prodotti dai moduli possono alimentarsi a vicenda, permettendo di espandere progressivamente la superficie informativa del target.
SpiderFoot può essere utilizzato dalla web UI oppure tramite CLI e dispone di oltre 200 moduli per attività come enumerazione di host e sottodomini, DNS, threat intelligence, blacklist, account social, bucket cloud, metadata, port scanning, banner grabbing e data-breach search.
Il suo punto di forza, quindi, non è semplicemente raccogliere informazioni, ma automatizzare il processo di discovery e correlazione: una singola scansione può generare nuovi elementi che vengono utilizzati da altri moduli per ampliare la ricognizione.
SpiderFoot in 30 Secondi #
Target (dominio, IP, email, username...)
        |
    Module (interroga una fonte o esegue un'operazione)
        |
     Event (il dato prodotto, passato agli altri moduli)
        |
    Entity (l'oggetto scoperto: subdomain, IP, email...)
        |
   Altri moduli si attivano sulle nuove entity
        |
   Correlation (pattern riconosciuti tra i risultati)
        |
    Validazione (Nmap, httpx, verifica manuale)
        |
     Attack Surface / Finding
SpiderFoot non sfrutta nulla da solo: produce intelligence correlata che alimenta le fasi successive dell’assessment.
Come Funziona #
| Concetto | Cosa significa |
|---|---|
| Target | Il seed di partenza: dominio, IP, subnet, email, username, nome, numero di telefono |
| Module | Un componente che interroga una fonte specifica (es. sfp_dns, sfp_shodan) o esegue un’operazione |
| Event | Il dato che un modulo produce e mette a disposizione degli altri moduli |
| Entity | L’oggetto concreto scoperto — un subdomain, un IP, un indirizzo email |
| Correlation | Un pattern che il motore di correlazione riconosce automaticamente tra eventi di moduli diversi |
Esempio concreto della catena module→event:
Target: example.com
   |
sfp_dns produce: INTERNET_NAME -> dev.example.com
   |
sfp_dnsresolve produce: IP_ADDRESS -> 203.0.113.45
   |
sfp_shodan produce: TCP_PORT_OPEN, WEBSERVER_BANNER
Ogni modulo si attiva sugli eventi che “ascolta”: non è un aggregatore che spara tutte le query insieme, è una catena che si costruisce da sola man mano che emergono nuove entity.
SpiderFoot vs Maltego vs Recon-ng vs TheHarvester #
| Tool | Approccio | Quando preferirlo |
|---|---|---|
| SpiderFoot | Automazione + correlazione automatica | Attack surface mapping ampio, monitoraggio continuo |
| Maltego | Pivot manuale + grafo visuale | Investigazione mirata dove il pivot guidato conta più della copertura |
| Recon-ng | Workflow modulare scriptabile | Automazione CLI ripetibile, controllo fine su ogni step |
| TheHarvester | Raccolta mirata e veloce | Primo giro rapido email/subdomain, senza bisogno di correlazione |
Non sono alternativi tra loro: un workflow comune parte da TheHarvester o SpiderFoot per la raccolta ampia, poi passa a Maltego quando serve seguire una relazione specifica a mano.
Installazione #
# Kali
sudo apt install spiderfoot

# Da sorgente
git clone https://github.com/smicallef/spiderfoot.git
cd spiderfoot
pip3 install -r requirements.txt
python3 ./sf.py -l 127.0.0.1:5001

# Docker
docker pull spiderfoot/spiderfoot:latest
docker run -p 5001:5001 spiderfoot/spiderfoot
Verifica versione e changelog sul repository ufficiale prima di ogni assessment — l’interfaccia e i nomi dei moduli cambiano tra release, non fidarti di un numero di versione scritto in una guida non aggiornata (questa inclusa).
Naviga a http://127.0.0.1:5001: dashboard con scan history, creazione nuovo scan, impostazioni moduli/API key.
Primo Scan #
1. Target Seed: domain, IP, subnet, email, nome, username, numero, indirizzo Bitcoin
2. Scan Name (opzionale)
3. Use Case:
   - All: tutti i moduli disponibili
   - Footprint: mapping pubblico senza probing diretto aggressivo
   - Investigate: footprint + moduli di threat intelligence
   - Passive: solo moduli che non contattano mai direttamente il target
4. Run Scan Now
Il tempo di completamento varia enormemente in base a numero di moduli abilitati, rate limit delle API configurate, e dimensione del target — non esiste un tempo “tipico” affidabile, guarda la progress bar dello scan in corso.
Passive vs Active: la Distinzione che Conta Davvero #
Non è un interruttore binario assoluto, è una proprietà per modulo:
Sorgente passiva — il modulo interroga una fonte terza (WHOIS, Certificate Transparency, breach database, Shodan via API). Il provider della fonte vede la tua query; il target normalmente no.
Interazione attiva — alcuni moduli contattano il target direttamente: DNS brute force, crawling web, verifica porte. Questi generano traffico che arriva davvero all’infrastruttura target.
Il profilo “Passive” nella UI disabilita i moduli della seconda categoria; “Footprint” e “All” li includono. Prima di uno scan in un contesto con vincoli OPSEC stretti, controlla la lista moduli effettivamente abilitati — non fidarti solo del nome del profilo.
Categorie di Moduli #
| Categoria | Intelligence tipica |
|---|---|
| DNS | Domini, record, subdomain |
| Network | IP, porte, ASN |
| Certificates | Certificati TLS, SAN, domini correlati |
| Indirizzi, pattern di formato aziendale | |
| Breach | Esposizioni in data breach noti |
| Threat Intelligence | Indicatori di compromissione, reputazione IP |
| Social | Profili e account collegati |
| Web | Tecnologie, banner, metadata |
| WHOIS/RIR | Dati di registrazione e ownership |
Come Interpretare i Risultati #
Dopo uno scan, la vista Browse mostra i risultati per tipo di dato. Cosa fare con ciascuno:
INTERNET_NAME → nuovo hostname trovato. Risolvilo, verifica se punta a un ambiente interessante (dev/staging/admin/vpn).
IP_ADDRESS → correla con ASN e netblock, poi valida i servizi realmente in ascolto — l’IP da solo non dice nulla sul rischio.
WEBSERVER_BANNER → indicazione di tecnologia/versione, punto di partenza per una verifica mirata, non una conferma di vulnerabilità.
LEAKED_CREDENTIALS → un’email compare in un breach storico. Questo non significa che la password associata sia ancora valida: verifica data del breach, se è comparso un hash o testo in chiaro, e tratta il riutilizzo come ipotesi da validare in modo autorizzato, non come credenziale pronta all’uso.
CO_HOSTED_SITE → un altro dominio condivide lo stesso IP. Non implica automaticamente la stessa ownership — è un’infrastruttura condivisa (hosting shared, CDN), va confermato prima di trattarlo come asset dello stesso target.
Correlazione Non È Prova #
SpiderFoot: dev.example.com -> IP 203.0.113.45 -> porta 443 -> Apache 2.4.xQuesto non significa “Apache vulnerabile” — significa “hai un asset che merita una verifica”. Il passo successivo è sempre:
SpiderFoot (discovery)
   |
Validazione attiva (Nmap, httpx, verifica manuale)
   |
Finding confermato
Workflow 1: External Attack Surface Mapping #
python3 sf.py -s targetcorp.com -u footprint -o csv -f attacksurface.csvOutput tipico da aspettarsi (i moduli DNS, certificati, Shodan e ricerca email lavorano in sequenza):
sfp_dns -> mail.targetcorp.com, www.targetcorp.com, vpn.targetcorp.com
sfp_sslcert -> certificato wildcard *.targetcorp.com, scadenza
sfp_shodan -> porta 443 aperta, Exchange rilevato su un host
sfp_hunter -> pattern email aziendali
Se ricevi errori di rate limit — configura le API key nelle Settings; senza key molti moduli passano dal tier gratuito a nessun risultato.
Se non trovi nulla — verifica che il dominio sia scritto correttamente e pubblicamente risolvibile (dig targetcorp.com) prima di sospettare un problema del tool.
Se lo scan va in timeout — aumenta __timeout in sf.conf, la rete verso alcune API può essere più lenta del previsto.
Workflow 2: Credential Exposure Intelligence #
1. New Scan -> Use Case: Investigate
2. Settings -> Modules -> abilita i moduli breach disponibili nella tua installazione
3. Run Scan[LEAKED_CREDENTIALS]
john.doe@targetcorp.com — comparso in breach storici, verifica fonte e data
admin@targetcorp.com — verifica se il dataset include hash o testo in chiaroPrima di qualsiasi azione: verifica quando è avvenuto il breach (una password di 8 anni fa ha probabilità molto più bassa di essere ancora in uso), e se il dataset riporta un hash (va craccato, non è immediatamente utilizzabile) o testo in chiaro. Solo dopo, in un contesto autorizzato, ha senso valutare il riutilizzo su VPN/SSO aziendali — mai assumerlo per certo.
Nota costi: alcuni moduli breach richiedono API a pagamento con free tier molto limitato (es. rate limit stretto su richiesta) — verifica i piani correnti dei provider prima di pianificare uno scan ampio.
Workflow 3: Subdomain Enumeration Massivo #
[sfp_dnsbrute]
enabled = True
wordlist = /usr/share/seclists/Discovery/DNS/subdomains-top1million-110000.txt1. New Scan: example.com
2. By Modules: sfp_dns, sfp_dnsbrute, sfp_certspotter, sfp_crtsh, sfp_dnsdumpster
3. Run Scan[INTERNET_NAME]
dev.example.com <- interessante
staging.example.com <- interessante
admin.example.com <- prioritarioIl tempo scala con la dimensione della wordlist — usa un set più piccolo (top 10k) per un primo giro, la wordlist completa solo se il primo giro giustifica l’investimento di tempo.
Export per la fase successiva:
grep "INTERNET_NAME" results.csv | cut -d',' -f2 > subdomains.txt
nmap -iL subdomains.txt -p 80,443,8080,8443 -sV -oA nmap_results
Custom Module #
Per una fonte non coperta dai moduli esistenti:
from spiderfoot import SpiderFootPlugin, SpiderFootEvent

class sfp_custom_example(SpiderFootPlugin):
    meta = {
        'name': 'Custom Example Module',
        'summary': 'Interroga una fonte interna',
        'useCases': ['Footprint', 'Investigate'],
        'categories': ['Passive DNS'],
    }

    opts = {'api_key': ''}
    optdescs = {'api_key': 'API key per il servizio'}
    results = None

    def setup(self, sfc, userOpts=dict()):
        self.sf = sfc
        self.results = self.tempStorage()
        for opt in userOpts:
            self.opts[opt] = userOpts[opt]

    def watchedEvents(self):
        return ['DOMAIN_NAME']

    def producedEvents(self):
        return ['INTERNET_NAME']

    def handleEvent(self, event):
        eventData = event.data
        if eventData in self.results:
            return
        self.results[eventData] = True

        res = self.sf.fetchUrl(f"https://api.example.com/lookup?domain={eventData}")
        if res['content']:
            evt = SpiderFootEvent('INTERNET_NAME', f"subdomain.{eventData}", self.__class__.__name__, event)
            self.notifyListeners(evt)
Registra il modulo e ricarica da Settings → Reload All Modules (GUI) o riavviando sf.py (CLI). Per la reference completa degli attributi meta e degli event type disponibili, la documentazione ufficiale nel repository resta la fonte più aggiornata.
Correlation Rules Custom #
- id: HIGH_RISK_EXPOSED_SERVICE
  name: "Exposed High-Risk Service"
  risk: HIGH
  trigger:
    event_type: TCP_PORT_OPEN
    port: [3389, 22, 445, 1433, 3306]
  action: ALERT
Le regole YAML trasformano combinazioni di eventi in finding classificati automaticamente per rischio, evidenziati nella dashboard senza dover scorrere manualmente ogni risultato.
Monitoraggio Continuo #
#!/bin/bash
DOMAIN="$1"
OUTPUT_DIR="/var/scans/$(date +%Y%m%d)"
mkdir -p "$OUTPUT_DIR"

python3 /opt/spiderfoot/sf.py -s "$DOMAIN" -u footprint -o csv -f "$OUTPUT_DIR/results.csv" -q

grep -i "LEAKED_CREDENTIALS\|MALICIOUS" "$OUTPUT_DIR/results.csv" > "$OUTPUT_DIR/alerts.txt"
[ -s "$OUTPUT_DIR/alerts.txt" ] && mail -s "OSINT Alert per $DOMAIN" security@company.com < "$OUTPUT_DIR/alerts.txt"crontab -e
0 2 * * * /opt/scripts/daily_osint_scan.sh targetdomain.comUno scan schedulato regolarmente intercetta nuovi subdomain, nuove esposizioni breach e nuovi servizi pubblicati — utile sia in un contesto offensivo di monitoraggio prolungato sia lato difesa.
Pipeline Toolchain Completa #
SpiderFoot (OSINT + correlazione)
   |
Amass (espansione DNS aggressiva)
   |
httpx / Aquatone (validazione HTTP, screenshot)
   |
Nmap (service enumeration attiva)
   |
Scanner di vulnerabilità dedicato| Tool | Ruolo nella pipeline |
|---|---|
| SpiderFoot | Raccolta OSINT iniziale e correlazione |
| Amass | Espansione subdomain più aggressiva |
| httpx | Validazione rapida di quali host rispondono su HTTP/HTTPS |
| Nmap | Enumerazione servizi attiva sui target confermati |
python3 sf.py -s $TARGET -u footprint -o csv -f spider_out.csv
grep "INTERNET_NAME" spider_out.csv | cut -d',' -f2 > subs_spider.txt

amass enum -passive -d $TARGET -o subs_amass.txt
cat subs_spider.txt subs_amass.txt | sort -u > all_subs.txt

nmap -iL all_subs.txt -p- -sV -oA nmap_full
OPSEC e Visibilità #
Il traffico che genera SpiderFoot è distinguibile per pattern: user-agent identificabile, query DNS a raffica, richieste sequenziali verso più API in una finestra breve. I provider delle fonti terze (Shodan, VirusTotal, servizi breach) registrano ogni query associata alla tua API key — questo vale indipendentemente da quanto tu configuri il resto.
Pratiche utili in un engagement autorizzato:
- distingui sempre moduli passivi da moduli attivi prima di uno scan con vincoli OPSEC stretti (vedi sopra);
- se lo scope lo richiede, instrada tramite proxy/Tor;
- aumenta il delay tra richieste (
__requestdelayinsf.conf) quando il rumore di rete è un problema per l’engagement, non solo per “nascondersi”; - usa API key dedicate al singolo cliente/assessment, revocale a fine incarico.
Non esiste una configurazione che renda SpiderFoot invisibile: l’automazione stessa produce un pattern riconoscibile, l’obiettivo realistico è ridurre rumore non eliminarlo.
Troubleshooting #
“Module failed to load” — dipendenza Python mancante per quel modulo specifico:
tail -f spiderfoot/sf.log | grep ERROR
pip3 install <libreria mancante>
Poi Settings → Reload All Modules.
Scan bloccato allo 0% — nessun modulo abilitato per il tipo di target scelto (es. hai messo un IP ma hai selezionato solo moduli che richiedono un dominio). Controlla il log (sf.log) per l’errore di avvio specifico.
Rate limit exceeded — aumenta il delay del modulo specifico in configurazione, o verifica il piano API presso il provider.
Risultati non salvati — verifica permessi e spazio disco sul file del database:
df -h /path/to/spiderfoot
chmod 644 spiderfoot/sfdb.db
Cheat Sheet #
# Installazione
git clone https://github.com/smicallef/spiderfoot.git
pip3 install -r requirements.txt

# GUI
python3 sf.py -l 127.0.0.1:5001

# CLI scan
python3 sf.py -s target.com -u all          # tutti i moduli
python3 sf.py -s target.com -u footprint    # mapping pubblico
python3 sf.py -s target.com -u investigate  # + threat intel
python3 sf.py -s target.com -u passive      # solo moduli passivi

# Output
-o csv -f results.csv
-o json

# Moduli specifici
-m sfp_dns,sfp_whois

# Automazione
-q                       # quiet mode
nohup python3 sf.py -s target.com -u all -o csv -f out.csv -q &
Hardening: Ridurre la Propria Superficie OSINT #
- rimuovi wildcard DNS e dismetti da DNS pubblico gli ambienti di staging/dev non più necessari;
- MFA su tutti i servizi esterni ed enforcement di password uniche, per ridurre il rischio del riutilizzo dopo un breach;
- monitoraggio breach proattivo sugli indirizzi aziendali principali;
- monitoraggio dei log di Certificate Transparency per il proprio dominio;
- limita il dettaglio tecnico pubblicato in job posting e profili social dei dipendenti.
Non mitigabile: WHOIS storico già pubblico, log di Certificate Transparency (obbligatori per policy CA), breach già avvenuti e pubblicati altrove.
FAQ #
Cos’è SpiderFoot? Un tool di OSINT automation che interroga decine di moduli/fonti e correla i risultati in un’unica base dati, con GUI web e CLI.
SpiderFoot è passivo o attivo? Dipende dal modulo, non è una proprietà unica del tool. I profili “Passive” abilitano solo moduli che non contattano mai direttamente il target; “Footprint” e “All” includono anche moduli attivi (DNS brute force, crawling).
Qual è la differenza tra SpiderFoot e Maltego? SpiderFoot automatizza e correla in autonomia; Maltego è guidato dal pivot manuale dell’utente con enfasi sulla visualizzazione a grafo. Spesso si usano in sequenza, non in alternativa.
SpiderFoot può sfruttare una vulnerabilità? No, è uno strumento di reconnaissance e correlazione. Per l’exploitation servono strumenti dedicati dopo la fase di validazione.
Trovare una credenziale in un breach significa che è ancora valida? No. È un’indicazione di esposizione storica — verifica data, formato del dato (hash o chiaro) e tratta un eventuale riutilizzo come ipotesi da validare in modo autorizzato.
Repository ufficiale: smicallef/spiderfoot. Uso consentito esclusivamente su target per cui hai autorizzazione scritta esplicita.